
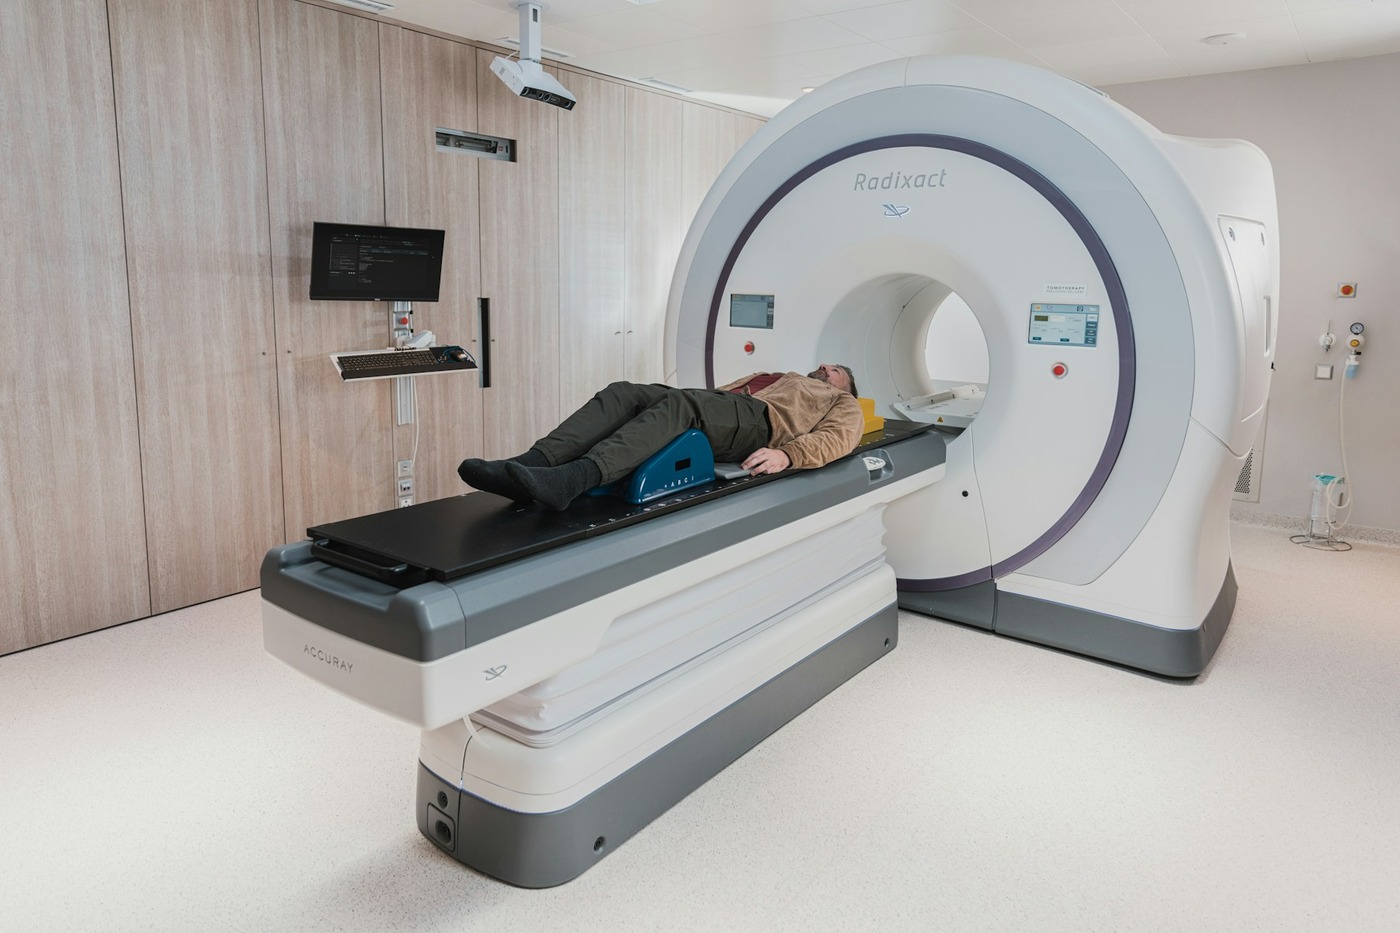
Штучний інтелект у медицині: діагностична підтримка без заміни лікаря потребує одночасно точності й здорового скепсису. Тут важливо знати базові поняття, але ще важливіше — бачити, яке спостереження підтверджує твердження, яке його обмежує і чому однаковий показник може означати різні речі в різних умовах.
Медична модель підтримує рішення, а не встановлює істину
Для «медична модель підтримує рішення, а не встановлює істину» важлива різниця між описом і вимірюванням. Опис відповідає, що помітно, а вимірювання задає шкалу, одиницю, процедуру та допустиму похибку. Два спостерігачі можуть погодитися з описом, але отримати різні числа через неоднакові правила. Узгоджена процедура робить результат відтворюваним і дозволяє порівняти його з тим, що було зафіксовано на етапі «моніторинг після впровадження виявляє нові помилки».
Важливо також не плутати точність запису з надійністю знання. Значення 12,347 виглядає переконливіше за 12,3, але додаткові знаки не мають сенсу, якщо вихідний інструмент розрізняє лише десяті. Те саме стосується складних термінів: вони корисні, коли точно відділяють одне явище від іншого, а не коли маскують відсутність даних або причинного пояснення.
Якість розмітки залежить від клінічного контексту
Якість розмітки залежить від клінічного контексту є окремою ланкою, але працює лише всередині ширшої системи. Спочатку визначають дані, потім уточнюють модель, після чого задають метрика і спосіб, яким виконуватиметься людський контроль. Якщо почати з готового результату, легко не помітити, що одна й та сама цифра могла виникнути за різних умов. Для теми «штучний інтелект у медицині» це принципово: коректне пояснення має показувати не лише що відбулося, а й чому саме та за яких припущень.
Типова помилка — оцінювати цей етап окремо від «чутливість і специфічність треба читати разом». Насправді вихід першого стає входом другого: неточність переходить далі, іноді посилюється, а іноді стає непомітною під час агрегування. Контрольна точка між етапами потрібна не для формальності, а щоб локалізувати причину відхилення. Так алгоритмічна система можна виправляти частинами, не перебудовуючи все рішення навмання.
Для цього аспекту корисним орієнтиром є WHO про етику ШІ для здоров’я: першоджерело уточнює терміни, межі методу та актуальні рекомендації.
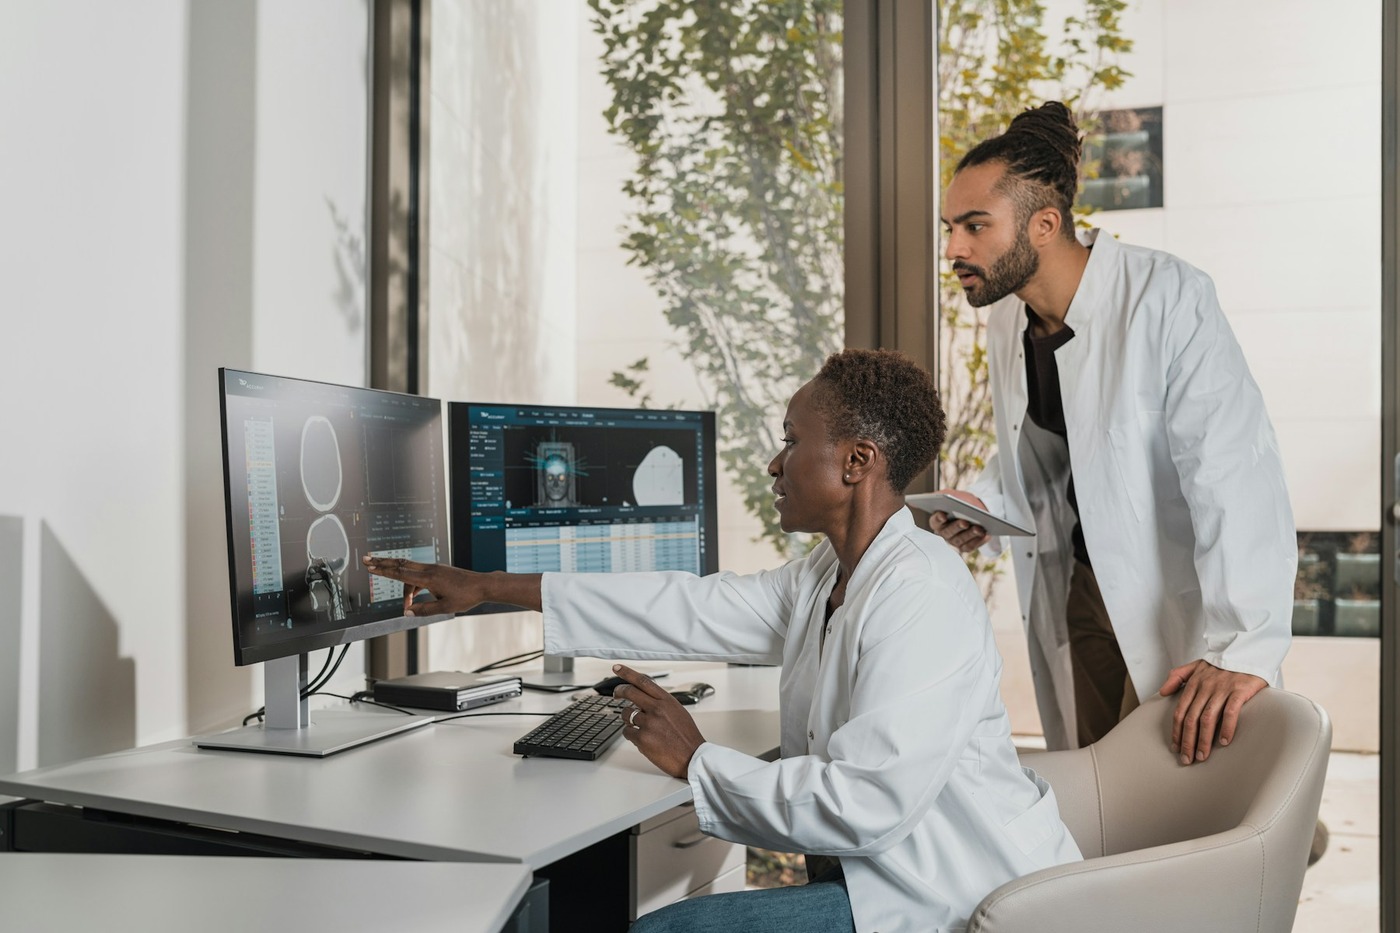
Карта взаємозв’язків
- Медична модель підтримує рішення, а не встановлює істину: визначає окрему контрольну точку в загальному механізмі.
- Якість розмітки залежить від клінічного контексту: визначає окрему контрольну точку в загальному механізмі.
- Чутливість і специфічність треба читати разом: визначає окрему контрольну точку в загальному механізмі.
- Базова поширеність змінює прогностичну цінність: визначає окрему контрольну точку в загальному механізмі.
- Зовнішня валідація перевіряє іншу лікарню й популяцію: визначає окрему контрольну точку в загальному механізмі.
Контрольна умова для «якість розмітки залежить від клінічного контексту»
Поняття «контрольна умова: якість розмітки залежить від клінічного контексту» стає зрозумілим через межу застосовності. Метод може добре працювати на типовому випадку й водночас помилятися на рідкісному; точний прилад не виправляє невдалий план; велика кількість даних не компенсує систематичного перекосу. Тому людський контроль має включати не лише середній результат, а й винятки, крайні значення та умови, за яких змінюється поведінка.
Типова помилка — оцінювати цей етап окремо від «пояснюваність має відповідати ризику рішення». Насправді вихід першого стає входом другого: неточність переходить далі, іноді посилюється, а іноді стає непомітною під час агрегування. Контрольна точка між етапами потрібна не для формальності, а щоб локалізувати причину відхилення. Так алгоритмічна система можна виправляти частинами, не перебудовуючи все рішення навмання.
Чутливість і специфічність треба читати разом
Щоб розібрати «чутливість і специфічність треба читати разом», корисно перевести поняття у спостережувані дії. Хтось задає початкову умову, алгоритмічна система реагує через визначений механізм, а результат порівнюють з критерієм. Такий запис одразу показує, де може з’явитися помилка: у вихідних даних, способі перетворення, одиницях вимірювання або інтерпретації. Без цього тема «штучний інтелект у медицині» перетворюється на набір правильних слів, які не допомагають перевірити реальну ситуацію.
Рідкісний виняток не скасовує загальної закономірності, але визначає межу її безпечного використання. Якщо результат правильний у 95 випадках зі 100, треба з’ясувати, що об’єднує решту п’ять і якою є ціна помилки. Для низькоризикового навчального завдання цього може бути достатньо; для рішення з істотними наслідками потрібен додатковий контроль або участь фахівця.
Базова поширеність змінює прогностичну цінність
У практиці базова поширеність змінює прогностичну цінність рідко має одну причину. На результат одночасно впливають якість дані, стабільність процедури, вибраний масштаб і зовнішні умови. Тому перший крок — зафіксувати те, що відомо до початку, а другий — відділити змінні, які можна контролювати, від тих, які лише спостерігають. Для алгоритмічна система це створює прозорий ланцюг від початкового стану до рішення.
Важливо також не плутати точність запису з надійністю знання. Значення 12,347 виглядає переконливіше за 12,3, але додаткові знаки не мають сенсу, якщо вихідний інструмент розрізняє лише десяті. Те саме стосується складних термінів: вони корисні, коли точно відділяють одне явище від іншого, а не коли маскують відсутність даних або причинного пояснення.
Зовнішня валідація перевіряє іншу лікарню й популяцію
Поняття «зовнішня валідація перевіряє іншу лікарню й популяцію» стає зрозумілим через межу застосовності. Метод може добре працювати на типовому випадку й водночас помилятися на рідкісному; точний прилад не виправляє невдалий план; велика кількість даних не компенсує систематичного перекосу. Тому людський контроль має включати не лише середній результат, а й винятки, крайні значення та умови, за яких змінюється поведінка.
Типова помилка — оцінювати цей етап окремо від «пояснюваність має відповідати ризику рішення». Насправді вихід першого стає входом другого: неточність переходить далі, іноді посилюється, а іноді стає непомітною під час агрегування. Контрольна точка між етапами потрібна не для формальності, а щоб локалізувати причину відхилення. Так алгоритмічна система можна виправляти частинами, не перебудовуючи все рішення навмання.
Пояснюваність має відповідати ризику рішення
Механіка розділу «пояснюваність має відповідати ризику рішення» пов’язує причину, дію та наслідок. Причина формує дані; дія реалізує модель; наслідок оцінюють через людський контроль. Якщо пропустити середню ланку, виникає спокуса приписати результат найпомітнішому фактору. Саме тому зріле пояснення теми «штучний інтелект у медицині» називає альтернативні причини і показує, якими даними їх можна відрізнити.
Рідкісний виняток не скасовує загальної закономірності, але визначає межу її безпечного використання. Якщо результат правильний у 95 випадках зі 100, треба з’ясувати, що об’єднує решту п’ять і якою є ціна помилки. Для низькоризикового навчального завдання цього може бути достатньо; для рішення з істотними наслідками потрібен додатковий контроль або участь фахівця.
Лікар оцінює симптоми поза цифровими даними
Для «лікар оцінює симптоми поза цифровими даними» важлива різниця між описом і вимірюванням. Опис відповідає, що помітно, а вимірювання задає шкалу, одиницю, процедуру та допустиму похибку. Два спостерігачі можуть погодитися з описом, але отримати різні числа через неоднакові правила. Узгоджена процедура робить результат відтворюваним і дозволяє порівняти його з тим, що було зафіксовано на етапі «пояснюваність має відповідати ризику рішення».
Важливо також не плутати точність запису з надійністю знання. Значення 12,347 виглядає переконливіше за 12,3, але додаткові знаки не мають сенсу, якщо вихідний інструмент розрізняє лише десяті. Те саме стосується складних термінів: вони корисні, коли точно відділяють одне явище від іншого, а не коли маскують відсутність даних або причинного пояснення.
Моніторинг після впровадження виявляє нові помилки
Моніторинг після впровадження виявляє нові помилки є окремою ланкою, але працює лише всередині ширшої системи. Спочатку визначають дані, потім уточнюють модель, після чого задають метрика і спосіб, яким виконуватиметься людський контроль. Якщо почати з готового результату, легко не помітити, що одна й та сама цифра могла виникнути за різних умов. Для теми «штучний інтелект у медицині» це принципово: коректне пояснення має показувати не лише що відбулося, а й чому саме та за яких припущень.
Типова помилка — оцінювати цей етап окремо від «медична модель підтримує рішення, а не встановлює істину». Насправді вихід першого стає входом другого: неточність переходить далі, іноді посилюється, а іноді стає непомітною під час агрегування. Контрольна точка між етапами потрібна не для формальності, а щоб локалізувати причину відхилення. Так алгоритмічна система можна виправляти частинами, не перебудовуючи все рішення навмання.
Моніторинг після впровадження виявляє нові помилки: робоча схема рішення
Механіка розділу «робоча схема: моніторинг після впровадження виявляє нові помилки» пов’язує причину, дію та наслідок. Причина формує дані; дія реалізує модель; наслідок оцінюють через людський контроль. Якщо пропустити середню ланку, виникає спокуса приписати результат найпомітнішому фактору. Саме тому зріле пояснення теми «штучний інтелект у медицині» називає альтернативні причини і показує, якими даними їх можна відрізнити.
Рідкісний виняток не скасовує загальної закономірності, але визначає межу її безпечного використання. Якщо результат правильний у 95 випадках зі 100, треба з’ясувати, що об’єднує решту п’ять і якою є ціна помилки. Для низькоризикового навчального завдання цього може бути достатньо; для рішення з істотними наслідками потрібен додатковий контроль або участь фахівця.
Додатковий приклад для «пояснюваність має відповідати ризику рішення»
Щоб розібрати «додатковий приклад: пояснюваність має відповідати ризику рішення», корисно перевести поняття у спостережувані дії. Хтось задає початкову умову, алгоритмічна система реагує через визначений механізм, а результат порівнюють з критерієм. Такий запис одразу показує, де може з’явитися помилка: у вихідних даних, способі перетворення, одиницях вимірювання або інтерпретації. Без цього тема «штучний інтелект у медицині» перетворюється на набір правильних слів, які не допомагають перевірити реальну ситуацію.
Рідкісний виняток не скасовує загальної закономірності, але визначає межу її безпечного використання. Якщо результат правильний у 95 випадках зі 100, треба з’ясувати, що об’єднує решту п’ять і якою є ціна помилки. Для низькоризикового навчального завдання цього може бути достатньо; для рішення з істотними наслідками потрібен додатковий контроль або участь фахівця.
Перевірка на іншому сценарії для «лікар оцінює симптоми поза цифровими даними»
У практиці перевірка на іншому сценарії: лікар оцінює симптоми поза цифровими даними рідко має одну причину. На результат одночасно впливають якість дані, стабільність процедури, вибраний масштаб і зовнішні умови. Тому перший крок — зафіксувати те, що відомо до початку, а другий — відділити змінні, які можна контролювати, від тих, які лише спостерігають. Для алгоритмічна система це створює прозорий ланцюг від початкового стану до рішення.
Важливо також не плутати точність запису з надійністю знання. Значення 12,347 виглядає переконливіше за 12,3, але додаткові знаки не мають сенсу, якщо вихідний інструмент розрізняє лише десяті. Те саме стосується складних термінів: вони корисні, коли точно відділяють одне явище від іншого, а не коли маскують відсутність даних або причинного пояснення.

Залишити відповідь